الخلفية التاريخية والخطوات الأولى
في هذا الفصل، نتعرّف إلى نماذج اللغة ونجري تجاربنا الأولى معها، تمهيدًا لما سنبنيه في بقية الدورة. لا تحتاج إلى معرفة مسبقة بتعلّم الآلة.
اقرأ هذا الدرس إلى جانب الدفتر البرمجي؛ فكل قسم عملي يقابله تمرين يمكنك تشغيله. تعكس أرقام النماذج والخدمات الواردة في الدرس وقت إعداد مادته، وقد تتغيّر مواصفاتها وإتاحتها.
أهداف التعلّم
بنهاية هذا الفصل، ستفهم:
- لماذا أصبحت نماذج اللغة الكبيرة مفيدة فجأة في أواخر 2022، مع أنّ الأسس الرياضية وراءها تعود إلى عقود سابقة.
- أنّ نموذج اللغة يقوم على عملية أساسية واحدة: حساب توزيع احتمالي على الرموز النصية التي قد تأتي تاليةً. نسمّي الوحدة التي يعالجها النموذج رمزًا نصيًا (Token).
- كيف أسهمت البيانات والقدرة الحاسوبية وبنية المحوّل (Transformer) في زيادة حجم التدريب بنحو مليار ضعف، أي تسع مراتب عشرية، خلال 13 عامًا، وما تعنيه أرقام التكلفة والطاقة وحجم البيانات.
- كيف تستدعي نموذج لغة عبر واجهة برمجية متوافقة مع OpenAI، وتستقبل النص تدريجيًا، وتنتقل بين النماذج.
- كيف تغيّر درجة الحرارة (Temperature) توزيع الاحتمالات، وكيف ترى هذا التوزيع عبر
logprobs. - كيف يعمل استخدام الأدوات: حلقة
whileتحيط باستدعاء لواجهة المحادثة، يرسل معه البرنامج سجل الرسائل في كل مرة. - ما دور النظام (System Role)، وكيف يختلف عن الأدوار
userوassistantوtool. - أنّ واجهة المحادثة تضيف طبقة فوق «توقّع الرمز التالي انطلاقًا من هذا النص»؛ فالرسائل والأدوار والأدوات تتحوّل إلى تسلسل واحد باستخدام قالب محادثة (Chat Template) خاص بالنموذج.
- الفرق بين واجهة إكمال النص (Completions) وواجهة إكمال المحادثة (Chat Completions)، وكيف يمكنك تطبيق القالب بنفسك للانتقال من إحداهما إلى الأخرى.
1. لحظة التحوّل
أُطلق ChatGPT في 30 نوفمبر 2022. وبعد خمسة أيام بلغ عدد مستخدميه مليون مستخدم، ثم بلغ 100 مليون خلال شهرين، ووُصف آنذاك بأنّه أسرع تطبيق استهلاكي نموًا (تقرير UBS، فبراير 2023). للمقارنة:
| المنتج | الوقت للوصول إلى 100 مليون مستخدم |
|---|---|
| ChatGPT | شهران |
| TikTok | 9 أشهر |
| سنتان ونصف | |
| 3 سنوات ونصف | |
| 4 سنوات ونصف | |
| أكثر من 5 سنوات |
بحلول 2024، كانت التقارير عن OpenAI تشير إلى أكثر من 200 مليون مستخدم نشط أسبوعيًا، وإيرادات سنوية تتجاوز 3.7 مليارات دولار، وانتشار بين شركات Fortune 500. وكانت Anthropic وGoogle DeepMind وMeta وMistral وxAI والمختبرات الصينية، مثل DeepSeek وQwen وKimi وGLM، تطلق نماذج متقدّمة بوتيرة تقارب إصدارًا كل ثلاثة أشهر.
سؤال للتأمّل: متى شعرت أنت لأول مرة بأنّ شيئًا مهمًا قد تغيّر؟
2. ما نموذج اللغة فعلًا؟
هو دالة تستقبل نصًا وتعيد توزيعًا احتماليًا لما قد يأتي بعده.
"The capital of France is" → "Paris" (probability 0.87)
                            → "a"     (0.04)
                            → "the"   (0.02)
                            → "located" (0.01)
                            → ...
أي إنّه، عند إعطائه تسلسل الرموز x₁, x₂, …, xₙ، يحسب:
P(xₙ₊₁ | x₁, x₂, …, xₙ)يُسنِد النموذج احتمالًا لكل رمز في قائمة الرموز التي يستطيع التعامل معها. وتضم هذه القائمة عادةً عشرات الآلاف أو مئات الآلاف من الرموز. مثلًا: تضم مفردات GPT-2 50,257 رمزًا، وLlama 3 128,256 رمزًا، وGemma 2 256,000 رمزًا.
هذه هي العملية الأساسية. أمّا المحادثة وكتابة البرامج و«الاستدلال» واستخدام الأدوات والوكلاء، فتُبنى فوقها عبر:
- التدريب على نصوص كافية ليصبح التوزيع مفيدًا.
- اختيار رمز وفق هذه الاحتمالات، ثم حساب احتمالات الرمز التالي وتكرار العملية لتوليد النص رمزًا بعد رمز. وهذا هو التوليد التتابعي: يعتمد كل رمز جديد على الرموز السابقة.
- تنظيم المدخلات والمخرجات وفق اصطلاحات، مثل قوالب المحادثة وتعريفات الأدوات وتعليمات النظام.
سنعيد بناء هذه الأجزاء من الصفر خلال الدورة.
3. نماذج اللغة ليست فكرة جديدة
تعود الأفكار وراء النماذج الحالية إلى عقود سابقة. إليك خطًا زمنيًا مختصرًا:
| السنة | ما الذي حدث؟ | المرجع |
|---|---|---|
| 1948 | أعمال شانون عن نظرية المعلومات؛ ومنها بدأت تقديرات إنتروبيا الإنجليزية المطبوعة بنحو 1–1.5 بت لكل حرف | نظرية رياضية للاتصال |
| السبعينيات | برنامج IBM الإحصائي للتعرّف على الكلام، مع جيلينك وميرسر | حكاية «كلما فصلت عالم لغويات…» أدناه |
| 1986 | انتشار استخدام الانتشار العكسي لتدريب الشبكات العصبية | Rumelhart وHinton وWilliams |
| 2003 | بنجيو وزملاؤه: نموذج لغة عصبي يتعلّم تمثيلات متجهية للكلمات | JMLR |
| 2010 | نماذج ميكولوف القائمة على الشبكات العصبية المتكرّرة تتفوّق على نماذج تسلسلات الرموز في مقياس الحيرة | Interspeech |
| 2013 | ظهور word2vec: تمثيل الكلمات بمتجهات ذات 300 بُعد يمكن إجراء عمليات تشابه عليها | Mikolov وزملاؤه |
| 2017 | «Attention Is All You Need»: بنية المحوّل، بـ65 مليون معامل، و8 معالجات رسومية، وتدريب استغرق 3.5 أيام | البحث |
| 2018 | GPT-1 بـ117 مليون معامل، وBERT بـ340 مليونًا؛ وانتشار نقل التعلّم | Radford، Devlin |
| 2019 | GPT-2 بـ1.5 مليار معامل؛ وحجب OpenAI أوزانه في البداية بسبب مخاوف إساءة الاستخدام | الإعلان |
| 2020 | GPT-3 بـ175 مليار معامل، وبحث كابلان عن قوانين التحجيم | قوانين التحجيم، GPT-3 |
| 2022 | InstructGPT والتعلّم المعزّز من التغذية الراجعة البشرية، وقوانين Chinchilla، وChatGPT | InstructGPT، Chinchilla |
| 2023 | GPT-4 وClaude وLlama 1/2، وانتشار النماذج مفتوحة الأوزان | |
| 2024 | Llama 3 بأحجام 8B و70B و405B، وClaude 3، وGemini 1.5 بسياق يبلغ مليون رمز | |
| 2025 | نماذج الاستدلال مثل o1 وo3 وClaude 3.7 وR1، وانتشار النماذج متعدّدة الوسائط |
نماذج تسلسلات الرموز (n-gram) تتوقّع الرمز التالي اعتمادًا على عدد ثابت من الرموز السابقة. أمّا مقياس الحيرة (Perplexity) فيقيس مدى قدرة النموذج على توقّع النص؛ وكلما انخفض، كان التوقّع أفضل.
ماذا يعني تقدير شانون: 1–1.5 بت لكل حرف؟ تخيّل ضاغط بيانات مثاليًا لا يفقد أي معلومات ويعرف الإنجليزية تمامًا. سيحتاج، في المتوسط، إلى نحو 1–1.5 بت لتمثيل الحرف، بدلًا من 8 بت في ASCII الخام. قدّر شانون ذلك في بحثه اللاحق سنة 1951 عبر مطالبة أشخاص بتخمين الحرف التالي في نص إنجليزي. هكذا أصبح لسؤال «إلى أي حد يمكن التنبؤ باللغة؟» جواب عددي. وهذه هي الكمية نفسها التي تسعى نماذج اللغة إلى تقليلها أثناء التدريب: خسارة أقل تعني ضغطًا أفضل وتنبؤًا أفضل. التنبؤ هو ضغط للمعلومات. ومن أرقام المقارنة الواردة في الدرس: نحو 2.5–3 بت لكل حرف مع gzip، ونحو 2 مع xz، ونحو 0.8 مع ضواغط مثل
nncpوcmix. هذه الأخيرة تتجاوز تقدير شانون البشري لأنّ النماذج الحديثة تستطيع التنبؤ بالإنجليزية أفضل من المشاركين في تجربته آنذاك.
حكاية «كلما فصلت عالم لغويات…» تُنسب عادةً إلى فريد جيلينك، أحد روّاد التعرّف على الكلام في IBM. وهي تعبّر عن تحوّل منهجي: اعتمدت الأنظمة المبكرة على قواعد يكتبها الخبراء يدويًا للنطق والنحو والاستثناءات. أمّا فريق جيلينك فدافع عن تعلّم الاحتمالات من كميات كبيرة من البيانات، بدلًا من إملاء القواعد على الآلة. ساعد هذا العمل في ترسيخ نماذج تسلسلات الرموز والتحوّل الإحصائي في معالجة الكلام واللغة. وكانت النكتة أنّ مغادرة عالم لغويات، وتوقّف تأثير قواعده اليدوية، تحسّن أداء النظام. المقصود نقد المنهج أكثر من نقد الأشخاص: في تلك المهمة وتلك المرحلة، تفوّقت النماذج التجريبية على القواعد المصمّمة يدويًا. الصياغة الأصلية والمناسبة غير محسومتين، لكن الأكاديمية الوطنية للهندسة تسجّل صيغة مفادها أنّ فصل عالم لغويات يخفض الرواتب ويحسّن أداء نظام التعرّف على الكلام.
تعود بنية المحوّل الأساسية إلى 2017، لكن ما يحيط بها تغيّر كثيرًا: انتقاء البيانات، والتدريب اللاحق مثل RLHF وDPO، وتحسين الاستدلال، ومعالجة السياقات الطويلة، وتنظيم استخدام الأدوات، وتعدّد الوسائط. لم تكن القفزة نتيجة فكرة واحدة، بل نتيجة تراكم هذه العوامل معًا.
4. ما الذي تغيّر إذن؟
اجتمعت ثلاثة عوامل:
- البيانات: وفّرت النصوص المتاحة على الويب تريليونات الرموز النصية.
- القدرة الحاسوبية: انخفضت تكلفة العملية الحسابية الواحدة على المعالجات الرسومية بنحو 1000 مرة بين 2012 و2024، وفق الأرقام المستخدمة في الدرس (Epoch AI).
- الخوارزمية: تتيح بنية المحوّل معالجة مواضع متعددة من النص بالتوازي أثناء التدريب، مما يساعد على تسريعه. وتُظهر التجارب أنّ أخطاء النموذج أثناء التدريب تقلّ بصورة يمكن توقّعها مع زيادة بيانات التدريب وعدد معاملات النموذج، وتوفير الحوسبة اللازمة. وتُعرف هذه العلاقات باسم قوانين التحجيم (Scaling Laws). لكن قيود الذاكرة والحوسبة وجودة البيانات تجعل التوسّع معقّدًا عمليًا.
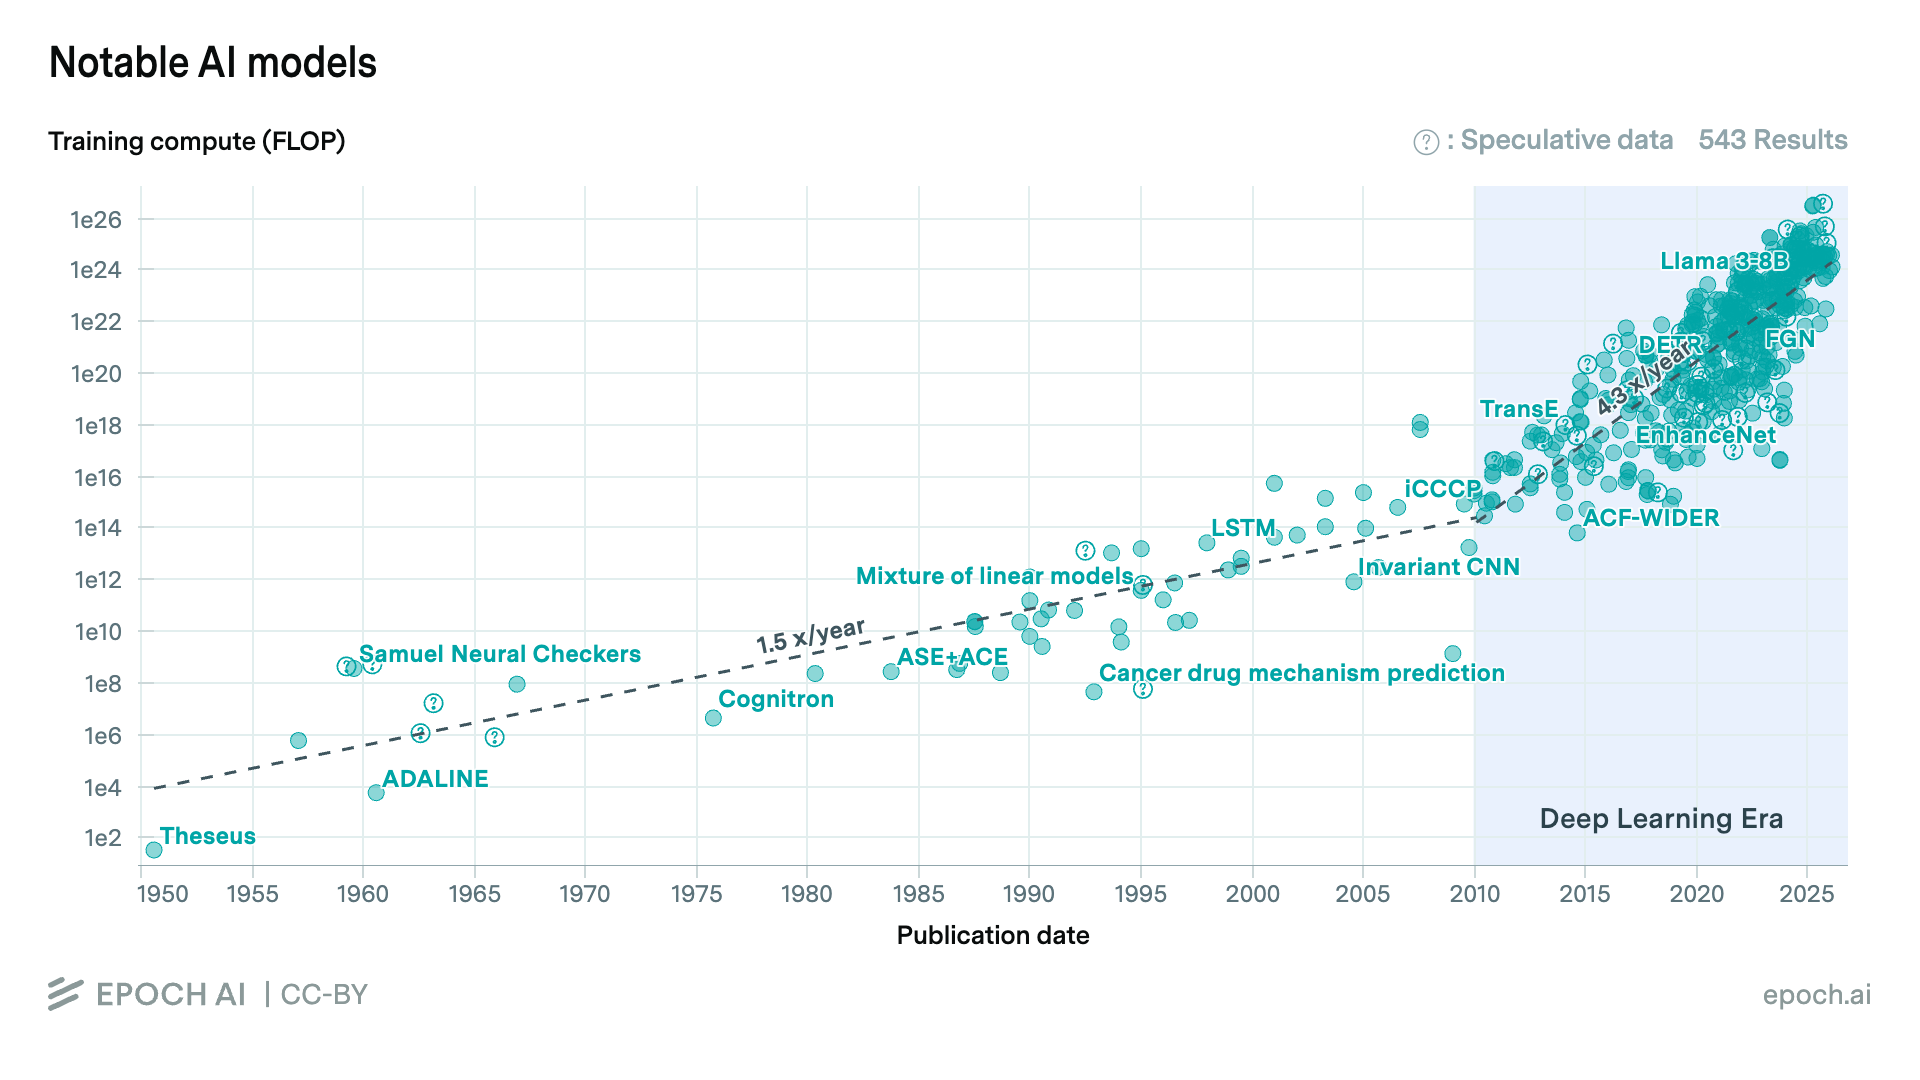
المصدر: Epoch AI.
| النموذج | السنة | العمليات الحسابية FLOPs | الرموز | القدرة الكهربائية | التكلفة بدولارات 2023 | مدة التدريب | نوع التقدير |
|---|---|---|---|---|---|---|---|
| AlexNet | 2012 | 4.7 × 10¹⁷ | 2B | — | $16 | 6 أيام | منشور |
| GPT-2 (774M) | 2019 | 5 × 10²¹ | 11B | — | $19K | — | منشور |
| GPT-3 175B | 2020 | 3.1 × 10²³ | 238B | 5 MW | $2M | 15 يومًا | منشور |
| PaLM 540B | 2022 | 2.5 × 10²⁴ | 780B | 4 MW | $3M | 64 يومًا | منشور |
| GPT-4 | 2023 | 2.1 × 10²⁵ | 5.4T | 20 MW | $37M | 95 يومًا | مقدّر |
| Llama 3.1-405B | 2024 | 3.8 × 10²⁵ | 15.6T | 23 MW | $53M | 89 يومًا | منشور |
| Grok 3 | 2025 | 3.5 × 10²⁶ | — | 110 MW | $218M | 90 يومًا | مقدّر |
| Grok 4 | 2025 | 5 × 10²⁶ | — | — | $388M | — | تخميني |
نوع التقدير يعكس تصنيف Epoch AI: «منشور» أي أعلنته الجهة المطوّرة، و«مقدّر» أي استُنتج من معلومات عامة، و«تخميني» أي تقدير تقريبي من مؤشرات غير مباشرة. تشير K إلى ألف، وM إلى مليون، وB إلى مليار، وT إلى تريليون.
تمثّل هذه الأرقام زيادة بنحو مليار ضعف، أي تسع مراتب عشرية، خلال 13 عامًا في حوسبة التدريب: من AlexNet سنة 2012 بتكلفة 16 دولارًا ومعالج رسومي يمكن وضعه في غرفة، إلى تقديرات Grok 4 سنة 2025 بنحو 388 مليون دولار وعلى نطاق هائل من الطاقة. ونمت حوسبة تدريب النماذج المتقدّمة بنحو 4–5 مرات سنويًا منذ 2010 (Sevilla وزملاؤه، 2022).
لتقريب هذه الأرقام:
- معالج H100 واحد ينفّذ نحو
10¹⁵ FLOP/sبدقة FP16. تدريب GPT-4 بافتراض2.1 × 10²⁵ FLOPsيحتاج نحو 665 سنة على معالج واحد عند استخدام كامل قدرته. لذلك تُستخدم آلاف المعالجات بالتوازي لنحو 95 يومًا. - مفاعل نووي واحد ينتج نحو 1 غيغاواط. ويمثّل تقدير استهلاك Grok 3، البالغ 110 ميغاواط، نحو 11% من هذه القدرة بصورة مستمرة لثلاثة أشهر.
- ويكيبيديا تعادل نحو 4 مليارات رمز. وبيانات تدريب GPT-4 المقدّرة بـ5.4 تريليونات رمز تعادل نحو 1350 نسخة من ويكيبيديا، وبيانات Llama 3.1 نحو 3900 نسخة.
- الإنسان يقرأ نحو 250 كلمة في الدقيقة، أي نحو 5.5 رموز في الثانية إذا استخدمنا التقريب الإنجليزي: الرمز يساوي نحو ثلاثة أرباع كلمة. قراءة 15.6 تريليون رمز بهذه السرعة تتطلّب نحو 90 ألف سنة بلا توقّف.
لم يكن أي عامل كافيًا وحده؛ اجتماع العوامل الثلاثة هو ما صنع لحظة التحوّل.
أهم نتائج قوانين التحجيم:
- كابلان وزملاؤه، 2020: درسوا كيف تنخفض خسارة التدريب مع زيادة عدد معاملات النموذج وحجم البيانات والحوسبة المستخدمة، ووجدوا علاقات منتظمة تساعد على توقّع أثر زيادة هذه الموارد. البحث.
- هوفمان وزملاؤه / Chinchilla، 2022: عند ثبات ميزانية الحوسبة، تكون النسبة التقريبية المناسبة 20 رمزًا لكل معامل. كثير من النماذج قبل 2022 لم تتدرّب على بيانات كافية قياسًا إلى حجمها. البحث.
مصدر بيانات الجدول: قاعدة نماذج Epoch AI. بعض القيم تقديرية أو تخمينية، كما توضّح التصنيفات.
5. الإعداد باستخدام OpenRouter
نستخدم في التجارب OpenRouter: واجهة تتيح الوصول إلى نماذج من جهات مختلفة بمفتاح واحد، مع خيارات مجانية ومدفوعة. كانت الخدمة تضم وقت إعداد الدرس نحو 300 نموذج من نحو 60 مزوّدًا. تدعم الخدمة صيغة طلبات متوافقة مع واجهة OpenAI، لذا يمكن استخدام حزمة OpenAI البرمجية معها.
أنشئ حسابًا في openrouter.ai.
أنشئ مفتاح API من صفحة المفاتيح.
إذا كنت تعمل من ملفات الدورة الأصلية في
chapters/1/، انسخ.env.exampleإلى.envوضع مفتاحك فيه:cp .env.example .env # then edit .env and replace the placeholder with your real keyافتح الدفتر البرمجي وشغّل خلية الإعداد. يحتوي الدفتر على قيمة مؤقتة للمفتاح؛ استبدلها بمفتاحك في نسختك المحلية.
ملفات .env مستبعدة من Git. أمّا إذا أدخلت المفتاح داخل الدفتر، فلا تشارك تلك النسخة ولا تحفظ المفتاح في مستودع عام.
لماذا نستخدم OpenRouter بدلًا من التعامل مباشرةً مع حزم OpenAI أو Anthropic؟
- مفتاح واحد لمزوّدين متعدّدين: يمكنك الانتقال بين GPT-4o وClaude وLlama وDeepSeek وQwen بتغيير اسم النموذج.
- خيارات مجانية: تتوافر بعض النماذج مجانًا ضمن حدود استخدام؛ وقد تتغيّر النماذج المتاحة.
- واجهة متوافقة مع OpenAI: تنطبق المفاهيم التي تتعلّمها هنا على استخدام الحزم الرسمية أيضًا.
ما حزمة OpenAI البرمجية، ولماذا تعمل مع OpenRouter؟
حزمة Python المسماة openai هي عميل HTTP خفيف. عند استدعاء client.chat.completions.create(...)، ترسل طلب POST إلى /v1/chat/completions يتضمّن رسائلك بصيغة JSON، ثم تحلّل الرد. وفي وضع البث تستقبل التحديثات التي يرسلها الخادم تباعًا عبر بروتوكول SSE. يمكنك تنفيذ الفكرة نفسها باستخدام requests أو curl؛ وظيفة الحزمة هي إعفاؤك من إدارة إعادة المحاولة وبنية الطلب وتحليل أحداث البث بنفسك.
يمكنك توجيهها إلى https://openrouter.ai/api/v1 للتعامل مع Claude وLlama وQwen وDeepSeek وغيرها لأنّ صيغة «متوافق مع OpenAI» أصبحت معيارًا عمليًا شائعًا. وتوفّر OpenRouter وTogether وGroq وFireworks وAnyscale وvLLM وOllama والخادم المدمج في llama.cpp واجهة مشابهة لـ/v1/chat/completions. وهكذا تستخدم عميلًا واحدًا واصطلاحات مشتركة مع خدمات كثيرة.
تحتفظ Anthropic وGoogle بواجهات أصلية وخصائص إضافية؛ مثل حقل system المستقل لدى Anthropic وإعدادات السلامة لدى Google. لكن الصيغة المتوافقة مع OpenAI توفّر لغة مشتركة بينها.
عمليًا، التغيير الأساسي عند الانتقال من OpenAI إلى OpenRouter هو عنوان base_url:
client = OpenAI(base_url="https://openrouter.ai/api/v1", api_key=...)الحقول الأساسية مثل messages وtools وtemperature وstream وlogprobs متشابهة. وتختلف بعض التفاصيل، مثل تعريف الأدوات وصيغ الردود والمدخلات متعدّدة الوسائط وحدود الاستخدام، لكن الجزء المشترك يكفينا في هذه الدورة.
6. تجربة عملية: مرحبًا بنموذج اللغة
← التمرين 1 في الدفتر. استدعِ نموذجًا مجانيًا وآخر مدفوعًا باستخدام الطلب نفسه.
لاحظ ما يلي:
- زمن الاستجابة: قد يتراوح زمن وصول أول رمز بين 200 ملّي ثانية وثانيتين؛ أمّا الزمن الكلي فيعتمد على طول المخرجات.
- البث التدريجي: تصل الرموز تباعًا عبر SSE. النموذج لا ينتظر إكمال الرد كله ليرسله؛ بل يرسل الرموز أثناء توليدها.
- معدّل التوليد: من المعدّلات التقريبية وقت إعداد الدرس: 50–100 رمز في الثانية للنماذج المتقدّمة، و500–2000 رمز في الثانية لدى خدمات متخصّصة مثل Groq وCerebras عند تشغيل نماذج أصغر مفتوحة الأوزان.
- اختلاف الجودة: نموذج مجاني ذو 7 مليارات معامل ونموذج متقدّم يتجاوز تريليون معامل ليسا متكافئين، لكن الفرق في المهام البسيطة قد يكون أصغر ممّا تتوقّع.
7. الطلب نفسه مع نماذج مختلفة
← التمرين 2 في الدفتر. أرسل طلبًا واحدًا إلى عدّة نماذج.
توقّع أولًا: أي نموذج سيكون أوضح؟ وأيّها أكثر إسهابًا؟ وأيّها أكثر وقوعًا في الخطأ؟
نستخدم طلبات بالعربية لمقارنة قدرة النماذج على فهم اللغة وصياغة الإجابة. تختلف حصة العربية في بيانات التدريب من نموذج إلى آخر، ويختلف معها الأداء، خصوصًا في اللهجات.
من أمثلة نماذج 2025 المستخدمة في هذه المقارنات: Claude وGPT-4o وGemini وQwen. لا تفترض أن ترتيبها ثابت؛ قارن دقة الإجابة وطبيعية اللغة وفهم اللهجة في المهمة التي تجرّبها.
8. الاحتمالات ودرجة الحرارة
يُختار كل رمز من توزيع احتمالي. تعيد درجة الحرارة (Temperature) تشكيل هذا التوزيع قبل أخذ العيّنة، بقسمة درجات النموذج الخام (logits) على T:
P(token) = softmax(logits / T)- عندما تقترب
Tمن الصفر، تقترب النتيجة من اختيار الرمز الأعلى احتمالًا دائمًا. - عند
T = 1، نستخدم التوزيع الأصلي للنموذج. - عندما تكبر
Tكثيرًا، يصبح التوزيع أقرب إلى التساوي بين الخيارات.
نطاقات تجريبية مفيدة:
T = 0.0–0.3: للإجابات المباشرة والبرمجة والمخرجات المنظّمة.T = 0.7–1.0: للمحادثة والكتابة الإبداعية.T = 1.2–1.8: للعصف الذهني والتنوّع المقصود؛ وقد يفقد النص تماسكه عند القيم المرتفعة، مثل ما فوق 1.5.
← التمرين 3 في الدفتر. جرّب الطلب نفسه عند T = 0 و0.7 و1.5. متى تبدأ النتيجة بفقدان تماسكها؟
إعدادات أخرى ستراها في الواجهات:
top_p: يحتفظ بأصغر مجموعة من الرموز يبلغ مجموع احتمالاتها القيمة المحدّدة أو يتجاوزها، ثم يعيد ضبط احتمالات المجموعة ليصبح مجموعها 1، ويختار منها الرمز التالي. Holtzman وزملاؤه، 2019.top_k: الاحتفاظ بأعلىkرموز احتمالًا فقط.frequency_penaltyوpresence_penalty: تقليل التكرار.repetition_penalty: إعداد شائع في Hugging Face، يستخدم عاملًا ضربيًا لمعالجة التكرار.
تضبط كثير من الواجهات top_p = 1.0 وتترك التحكّم الأساسي لدرجة الحرارة.
9. رؤية التوزيع الاحتمالي
كان المثال P("Paris" | ...) = 0.87 في القسم 2 توضيحيًا. الآن سنرى أرقامًا فعلية.
يمكن للواجهة المتوافقة مع OpenAI إرجاع logprobs=True, top_logprobs=5: لكل رمز مولّد، نحصل على لوغاريتم الاحتمال الذي أسنده النموذج إليه، وعلى أفضل خمسة بدائل.
← التمرين 3، خلية logprobs. اطبع جدولًا لكل درجة حرارة: الرمز، واحتماله، وأفضل خمسة بدائل.
راقب الأنماط التالية في التجربة:
- عند
T = 0، قد يكون احتمال الرمز المختار مرتفعًا، مثل أكثر من 0.5 أو 0.9، مع احتمالات صغيرة للبدائل. - عند
T = 0.7، قد تصبح احتمالات البدائل أقرب إلى احتمال الرمز المختار، فتصل احتمالاتها إلى 10–30%. - عند
T = 1.5، قد يظهر رمز لم يكن ضمن أفضل خمسة خيارات في التجارب منخفضة الحرارة. أي إنّ الفروق بين الاحتمالات تصغر، فتزداد فرصة اختيار رموز كانت أقل احتمالًا.
ملاحظة عن الحتمية: حتى عند T = 0 قد تختلف النتائج أحيانًا، للأسباب التالية:
- عدم الحتمية على المعالج الرسومي: تعتمد نتائج جمع الأعداد العشرية على ترتيب العمليات، وقد تغيّر نوى CUDA هذا الترتيب لتحقيق التوازي.
- تجميع الطلبات في دفعات: قد يُنفّذ طلبك مع طلبات مستخدمين آخرين، وتتغيّر مسارات التنفيذ باختلاف شكل الدفعة.
- إعدادات افتراضية: مثل
top_pأقل من 1 أو عدم تثبيتseed. - التوليد التخميني: يقترح نموذج مساعد رموزًا أولية يتحقّق منها النموذج الأساسي؛ وقد تظهر فروق تقريب عددي صغيرة في بعض التطبيقات.
الحصول على نتائج قابلة للتكرار في أنظمة الخدمة الفعلية يحتاج إلى ضبط المنظومة كاملةً: البذور العشوائية وأحجام الدفعات والنوى الحتمية. مناقشة Thinking Machines، 2025. قابلية التكرار خاصية نعمل على تحقيقها، وليست نتيجة تلقائية.
10. نافذة السياق
يرى النموذج عددًا محدودًا من الرموز في المرة الواحدة. بعد تجاوز الحد، قد تقتطع الواجهة جزءًا من المدخلات أو تعيد خطأ.
اتّسعت نوافذ السياق بسرعة، كما توضّح أمثلة الدرس التاريخية:
- GPT-2، سنة 2019: 1024 رمزًا.
- GPT-3، سنة 2020: 2048 رمزًا.
- GPT-3.5، سنة 2022: من 4096 إلى 16 ألفًا لاحقًا.
- GPT-4، سنة 2023: من 8 آلاف إلى 32 ألفًا ثم 128 ألفًا.
- Claude 2، سنة 2023: 100 ألف.
- Claude 3.5 و4، خلال 2024–2025: 200 ألف، ومليون لبعض فئات المؤسسات.
- Gemini 1.5 Pro، سنة 2024: مليون، مع عرض تجريبي لعشرة ملايين.
- Llama 4 وGPT-4.1، سنة 2025: مليون أو أكثر.
لكن «يدعم مليون رمز» لا تعني «يستفيد جيدًا من مليون رمز». تختبر تجارب الإبرة في كومة القش قدرة النموذج على استرجاع معلومة داخل سياق طويل. وقد تتراجع دقة الاسترجاع قبل بلوغ الحد المعلن؛ ويختلف ذلك بحسب النموذج وطول النص وموضع المعلومة وطبيعة الاختبار.
كما أنّ كلفة الانتباه الذاتي المباشر تزداد بمقدار O(n²) مع طول التسلسل. نظريًا، قد يتطلّب سياق من مليون رمز نحو مليون ضعف عمليات الانتباه لسياق من ألف رمز. تقلّل تقنيات مثل FlashAttention والانتباه الحلقي والمتناثر والخطي هذه الكلفة أو كلفة تنفيذها، لكن السياقات الطويلة تظل مكلفة.
11. الهلوسة
أثناء التدريب، يتعلّم النموذج إعطاء احتمالات أعلى للرموز التي تظهر فعلًا في نصوص التدريب. وتقيس دالة الخسارة مدى نجاحه في ذلك. لكن النجاح في توقّع النص لا يضمن صحة المعلومات التي يولّدها؛ فقد ينتج إجابة مقنعة تتضمّن معلومات خاطئة أو مراجع غير موجودة.
← التمرين 5 في الدفتر. اخترع مصطلحًا واطلب مرجعًا حقيقيًا عنه. لاحظ هل يختلق النموذج مرجعًا ويقدّمه بثقة.
أمثلة على المشكلة:
- في قضية Mata ضد Avianca، في يونيو 2023، قُدّمت مذكرة تتضمّن ستة استشهادات بقضايا مختلقة ولّدها ChatGPT، وفُرضت غرامة قدرها 5000 دولار على المحاميين ومكتبهما.
- يناقش الدرس أيضًا اختلاق المعلومات في الأسئلة الطبية، مع الإشارة إلى هذه الدراسة. تختلف المعدّلات بحسب النموذج والسؤال وطريقة التقييم.
- حتى النماذج المتقدّمة قد تختلق مراجع أكاديمية، وتختلف النسب بحسب المجال وصياغة الطلب. الفكرة الأساسية: الثقة في الأسلوب ليست دليلًا على وجود المصدر.
طرق للتخفيف، سنعود إلى بعضها لاحقًا:
- التوليد المعزّز بالاسترجاع (RAG): ربط الإجابة بمستندات حقيقية.
- استخدام الأدوات: البحث عن المعلومة بدلًا من الاعتماد على ما تعلّمه النموذج فقط.
- درجة حرارة صفر ومخرجات منظّمة: قد يقلّلان التباين، لكنهما لا يعالجان الهلوسة وحدهما.
- التحقّق والاتّساق بين المحاولات: مقارنة إجابات متعدّدة.
- الضبط الدقيق بأمثلة «لا أعرف»: مهم، لكنّه أصعب ممّا يبدو.
للنقاش: لماذا يحدث ذلك؟ وما الذي نحتاج إليه فعلًا لمعالجته؟
12. استخدام الأدوات: استدعاء واحد
يمكن للنموذج أن يطلب من البرنامج استدعاء دالة. هذه هي الفكرة الأساسية وراء كثير من أدوات المساعدة البرمجية والوكلاء.
ساعد إطلاق OpenAI لاستدعاء الدوال في يونيو 2023 على توحيد هذا النمط، ثم دعمته جهات ونماذج أخرى، منها Anthropic وGoogle وMistral وLlama وQwen. وأطلقت Anthropic بروتوكول MCP في نوفمبر 2024 لتوحيد طريقة إتاحة الأدوات للعملاء.
← التمرين 6، الخلية الأولى. أرسل تعريفًا في tools=[...] وافحص الرد الخام. بدلًا من نص content، قد تحصل على tool_calls.
النموذج لا ينفّذ الدالة؛ بل يطلب منك تنفيذها وإبلاغه بالنتيجة. التنفيذ الفعلي يحدث في برنامجك.
13. استخدام الأدوات: حلقة التنسيق
لا يكفي استدعاء واحد. النمط الكامل هو حلقة:
1. send messages + tools to the model
2. if response has tool_calls:
     run each tool, append result as role="tool"
     loop back to step 1
3. else:
     done — print final answer
أي: أرسل الرسائل والأدوات، ثم نفّذ ما يطلبه النموذج وأضف النتائج بدور tool وأعد الإرسال. عندما يرسل إجابة نهائية بدلًا من طلب أداة، تنتهي الحلقة.
← التمرين 6، خلية التنسيق. قارن الطقس بين القاهرة ونيويورك. راقب كيف يكبر محتوى الطلب مع كل دورة: استدعاءان للأداة ثم إجابة نهائية.
← التمرين 6ب. مساعد لمواقيت الصلاة يستخدم أداتين مختلفتين: get_current_time(city) وget_prayer_times(city, date). يستدعي الأولى لمعرفة الوقت الحالي، ثم يستخرج التاريخ لاستخدامه في الثانية، ويحدّد الصلاة القادمة ويحسب الزمن المتبقي. يجسّد هذا المثال تسلسل الأدوات بصورة أوضح من تكرار استدعاء الأداة نفسها، لأنّ الإجابة تحتاج أيضًا إلى حساب يعتمد على نتيجتي الأداتين.
ثلاث أفكار تظهر هنا عمليًا:
- في المثال الذي نستخدمه، يحتفظ برنامجك بسجل المحادثة ويرسله مع كل طلب جديد. ويشمل السجل رسائل المستخدم وردود النموذج ونتائج الأدوات، حتى يستطيع النموذج متابعة ما حدث في الخطوات السابقة.
- تقوم آلية الوكيل الأساسية على حلقة
while: تحيط باستدعاء محادثة قادر على طلب الأدوات. وتظهر هذه الفكرة، بصور أكثر تعقيدًا، في أدوات مثل Claude Code وCursor وAutoGPT وLangGraph. - تكلفة الرموز تتراكم: تعيد كل دورة إرسال السابق وتعريفات الأدوات. لذلك قد تنمو رموز الإدخال وفق مجموع مثل
1+2+3+…+n، وقد تستهلك محادثة من عشر دورات ما يعادل 5–10 أضعاف مدخلات عشرة استدعاءات مستقلة.
14. دور النظام
لكل رسالة حقل role. استخدمنا حتى الآن user، لكن توجد أدوار أخرى:
system: تعليمات المحادثة العامة التي يضعها مطوّر التطبيق: الشخصية والقواعد والقيود.user: مدخلات المستخدم.assistant: ردود النموذج السابقة، التي نعيد إرسالها للحفاظ على السياق.tool: نتيجة استدعاء أداة، ردًا على رسالة من المساعد تحتوي علىtool_calls.
تضع واجهة Anthropic تعليمات system في حقل مستقل ضمن الطلب، بينما تستخدم واجهة OpenAI رسالة ضمن القائمة. الفكرة متشابهة وإن اختلف تمثيلها.
← التمرين 7. اطرح سؤال الفيزياء نفسه مع تعليمات نظام لشخصية معلّم رسمي، ثم لشخصية قرصان. راقب تغيّر الأسلوب.
15. ماذا يرى النموذج فعلًا؟
كنت ترسل رسائل منظّمة، مثل:
[{"role": "system", "content": "..."}, {"role": "user", "content": "..."}]لكن بنية طلب API ليست ما يُقدَّم مباشرةً إلى النموذج. ما يتلقّاه النموذج هو تسلسل واحد من الرموز.
تجمع الواجهة رسائلك وفق قالب محادثة خاص بعائلة النموذج، ثم تحوّل النص إلى رموز. تختلف الرموز الخاصة وعلامات الأدوار وطريقة تمثيل الأدوات بين العائلات. أمثلة:
Llama 3:
<|begin_of_text|><|start_header_id|>system<|end_header_id|>
…<|eot_id|>…
Qwen:
<|im_start|>system\n…<|im_end|>
<|im_start|>user\n…<|im_end|>
Gemma:
<start_of_turn>user\n…<end_of_turn>
<start_of_turn>model\n
Mistral Instruct:
[INST] … [/INST]قد يجيب النموذج حتى مع قالب غير مناسب، لكن الجودة قد تتراجع، وقد يتعطّل استدعاء الأدوات. تقرأ دالة apply_chat_template القالب من إعدادات مُجزّئ النص (Tokenizer)، الذي يحوّل النص إلى رموز يستطيع النموذج التعامل معها. تُحفظ هذه الإعدادات في ملفات مثل tokenizer_config.json، وتستخدمها الدالة لتطبيق الصيغة المناسبة.
← التمرين 8. حمّل مُجزّئ النص لـgpt-oss-20b، واستدعِ apply_chat_template، واطبع النص الخام الناتج.
هنا نرى ما تخفيه الواجهة: المحادثة طبقة تنظيمية فوق «توقّع الرمز التالي من هذا النص».
16. كيف تُمثَّل الأدوات في الطلب الخام؟
تعريفات الأدوات ليست قناة منفصلة عن تسلسل الإدخال. تُحوّل إلى نص ضمن الطلب نفسه، بالصيغة التي تدرب عليها النموذج: JSON Schema أو تعريفات تشبه TypeScript أو XML، بحسب العائلة.
← التمرين 8، خلية الأدوات. طبّق القالب مع tools=[...]. لاحظ مقدار ما تشغله تعريفات الأدوات مقارنةً بسؤال المستخدم.
يفسّر ذلك عدة أمور:
- لماذا تستهلك تعريفات الأدوات رموزًا؟ قد يشغل تعريف أداة ذات خمسة حقول نحو 200–500 رمز قبل بدء المحادثة؛ وعشر أدوات قد تضيف 2000–5000 رمز لكل دورة.
- لماذا يختلف دعم الأدوات بين النماذج؟ النموذج المتدرّب على صيغة معيّنة قد لا يجيد صيغة أخرى بالقدر نفسه.
- لماذا تهم كتابة الوصف؟ وصف الأداة جزء فعلي من المدخلات؛ اكتبه كما تكتب توثيقًا واضحًا للبرنامج.
17. إكمال النص، لا المحادثة
استخدمنا حتى الآن واجهة المحادثة /v1/chat/completions التي تستقبل رسائل بأدوار. توجد أيضًا واجهة أبسط وأقدم: /v1/completions. تستقبل نصًا خامًا وتكمله، دون أن تضيف أدوارًا أو تعليمات نظام أو قالبًا من عندها.
تطبّق واجهة المحادثة القالب خلف الكواليس، بينما تُمرّر واجهة إكمال النص ما ترسله مباشرةً بعد تحويله إلى رموز. لذلك تتحكّم أنت في كل رمز من المدخلات.
هذا يوضّح فكرة الإكمال البرمجي، كما في أدوات مثل GitHub Copilot: تكتب جزءًا من دالة، فيكمل النموذج بقيتها. في هذا النوع من الاستخدام، نريد استمرار البرنامج نفسه لا تغليفه بمحادثة.
← التمرين 9. أرسل دالة Python غير مكتملة وجملة إنجليزية غير مكتملة عبر واجهة إكمال النص، وراقب كيف يكمل النموذج كليهما.
18. المحادثة عبر واجهة إكمال النص
ماذا لو أردت استخدام نموذج ضُبط لاحقًا لاتباع التعليمات عبر واجهة إكمال النص؟
طبّق قالب المحادثة بنفسك باستخدام tokenizer.apply_chat_template، ثم أرسل النص الناتج إلى /v1/completions. يرى النموذج القالب الذي تدرّب عليه فيتصرّف كمساعد، بينما تحتفظ بالتحكّم في الطلب الخام.
لماذا تفعل ذلك؟ قد تتيح بعض الخدمات عبر واجهة إكمال النص خصائص لا توفّرها عبر واجهة المحادثة، مثل عرض احتمالات الرموز أو إرسال بداية إجابة وترك النموذج يكملها.
← التمرين 10. طبّق قالبَي Qwen وgpt-oss-20b، وأرسل النصوص الناتجة عبر /v1/completions، ثم قارنها بواجهة المحادثة. الهدف أن ترى كيف يمكن تمثيل المحادثة على أنّها قالب يتبعه إكمال؛ وقد تختلف النتائج الفعلية بسبب إعدادات الخدمة والتوليد.
تكشف التجربة أيضًا ما تضيفه العائلات المختلفة إلى القالب. قالب Qwen مباشر، مثل <|im_start|>system\n...<|im_end|>. أمّا مثال gpt-oss-20b فيضيف هوية مثل "You are ChatGPT..."، ويحوّل دور system إلى developer، ويستخدم قنوات مثل analysis وfinal. تخفي واجهة المحادثة هذه التفاصيل، بينما يكشفها فحص القالب.
خلاصة الفصل
- لحظة أواخر 2022 جاءت من تراكم البيانات والحوسبة وبنية المحوّل، لا من فكرة جديدة واحدة. وصل ChatGPT إلى 100 مليون مستخدم خلال شهرين.
- العملية الأساسية لنموذج اللغة هي توزيع احتمالي للرمز التالي بناءً على السابق. وتُبنى المحادثة والأدوات والاستدلال والوكلاء فوقها.
- حوسبة التدريب اتّسعت بنحو مليار ضعف، أي تسع مراتب عشرية، خلال 13 عامًا وفق أرقام الدرس، مع نمو سنوي يقارب 4–5 مرات، وفارق هائل في التكلفة بين أمثلة 2012 و2025.
- قوانين التحجيم، مثل كابلان وChinchilla، تصف علاقات منتظمة بين الخسارة والحوسبة والمعاملات والبيانات.
- درجة الحرارة تغيّر توزيع الاحتمالات، و
logprobsتساعدك على رؤيته. ولا تضمنT = 0وحدها تكرار النتائج تمامًا في كل منظومات الخدمة. - نوافذ السياق اتّسعت من ألف رمز تقريبًا إلى مليون أو أكثر، لكن طول النافذة لا يضمن جودة استرجاع المعلومات، والانتباه المباشر تربيعي الكلفة.
- الهلوسة مرتبطة بأنّ هدف التنبؤ لا يضمن الحقيقة. الاسترجاع والأدوات والتحقّق وسائل للتخفيف، وليست ضمانًا مطلقًا.
- في المثال الذي نستخدمه، يحتفظ برنامجك بسجل المحادثة ويرسله مع كل طلب جديد. واستخدام الأدوات يقوم على حلقة تنسيق حول الاستدعاء.
- قوالب المحادثة تجمع الأدوار والرسائل وتعريفات الأدوات في تسلسل واحد من الرموز.
- واجهتان، وعملية أساسية واحدة: إكمال النص يتابع نصًا خامًا، وإكمال المحادثة يطبّق قالبًا أولًا. يمكنك تطبيق القالب بنفسك لرؤية ما تخفيه الواجهة.
- في بقية الدورة سنعيد بناء المكوّنات التي استخدمناها اليوم، بدءًا من عدّ الكلمات في نصوص شكسبير.
أسئلة للنقاش
- رأيت النص الخام الذي يتلقّاه النموذج. ما الذي فاجأك فيه؟
- إذا كان النموذج يتنبّأ بالرمز التالي فقط، فكيف «يستدل»؟ وكيف «يستخدم أداة»؟
- أين ينبغي ألّا نستخدم نموذج لغة؟ وما أنواع الإخفاق التي رأيناها؟
- حلقة استخدام الأدوات هي حلقة
while. لماذا نشعر مع ذلك بأنّها وكيل؟ - إذا نمت حوسبة التدريب 4–5 مرات سنويًا، فكم يمكن أن يستمر ذلك؟ وأي الموارد ستصبح القيد أولًا: المال أم الكهرباء أم المعالجات أم البيانات؟